스캔 파일에 많은 저장 공간이 필요한 이유
스캐너는 페이지를 이미지로 캡처합니다. 스캔한 페이지에서 보이는 것은 픽셀로 이루어진 격자이며, 문서 스캔에서는 보통 페이지당 이미지 하나가 사용됩니다. 일부 스캔 앱은 페이지를 검색할 수 있도록 문자 인식(OCR)으로 생성한 보이지 않는 텍스트 레이어를 추가합니다. 그래도 눈에 보이는 페이지 이미지는 픽셀 격자로 남습니다. 반면 문서 작성 프로그램에서 직접 내보낸 PDF는 같은 페이지를 문자, 글꼴과 선으로 표현합니다. 따라서 네 페이지짜리 편지를 PDF로 내보내면 파일이 매우 작을 수 있지만, 같은 편지를 스캔하면 수 MB를 차지할 수 있습니다.
스캔 파일에 필요한 바이트 수는 주로 다음 네 가지에 따라 달라집니다.
- 픽셀 크기: 픽셀 단위의 너비 × 높이로 나타냅니다. 용지 크기와 스캔 해상도에 따라 결정됩니다.
- 색상: 컬러 스캔은 픽셀당 그레이스케일보다 많은 정보를 저장하며, 그레이스케일은 순수 흑백보다 많은 정보를 저장합니다.
- 이미지 노이즈와 배경: 종이 질감, 그림자, 접힌 자국이나 회색빛 배경도 압축 과정에서는 실제 이미지 세부 정보로 취급되어 공간을 차지합니다. 반면 균일한 흰색 영역은 매우 적은 용량으로 저장할 수 있습니다.
- 인코딩: 어떤 압축 방식으로 이미지를 어느 정도의 품질로 저장하는지입니다.
따라서 페이지가 네 장이라는 사실이나 DPI 값, A4 형식만으로 페이지당 MB 용량이 정해지지는 않습니다. 같은 종이를 스캔한 두 파일도 기기와 설정에 따라 크기가 크게 달라질 수 있습니다. PDF 전체에 하나의 해상도가 적용되는 것도 아닙니다. 삽입된 이미지마다 고유한 픽셀 크기가 있으며, 한 파일 안에 스캔 페이지, 내보낸 텍스트 페이지와 사진이 섞여 있을 수 있습니다.
PDF에서 이미지로 된 페이지를 구별하는 방법
파일이 대부분 이미지 페이지로 이루어져 있다면 대개 파일 용량의 대부분을 이 이미지들이 차지합니다. 다음 절에서는 바로 이 부분을 다룹니다.
처음부터 용도에 맞게 스캔하기
종이가 아직 스캐너에 있을 때 가장 큰 영향을 줄 수 있습니다. 이 단계에서 생성할 픽셀 수와 색상 정보의 양을 결정하기 때문입니다. 스캔할 때 빠진 세부 정보는 나중에 압축해도 복원할 수 없습니다. 반대로 너무 높은 스캔 해상도도 PDF 압축 도구로 나중에 낮출 수 없습니다. 압축 도구는 이미지의 픽셀 크기를 변경하지 않기 때문입니다.
따라서 용도에 맞게 설정하세요. 수신자가 무엇을 읽을 수 있어야 하며, 어떤 세부 정보가 증빙 역할을 하나요? 성적증명서, 확인서나 계약서에서는 작은 숫자, 도장, 서명, 인장과 페이지 번호나 검증 코드처럼 페이지 가장자리에 있는 정보가 여기에 해당하는 경우가 많습니다.
300 DPI로 스캔해야 할까요, 더 높게 스캔한 뒤 나중에 압축해야 할까요?
Adobe는 Acrobat에서 적응형 압축을 사용하는 스캔 작업에 컬러와 그레이스케일은 300 DPI, 흑백은 600 DPI를 권장합니다(Adobe: 스캔 PDF 설정). 이는 해당 작업 방식에 적합한 출발점이지만, 일반적인 규정이나 수신자의 요구 사항은 아닙니다. 픽셀을 늘릴 가치가 있는 경우는 필요한 내용이 더 잘 보이게 될 때뿐입니다. 가장 작은 글씨가 300 DPI에서도 이미 선명하게 읽힌다면 해상도를 높여도 주로 파일 크기만 커집니다.
‘높은 해상도로 스캔한 뒤 나중에 줄이기’가 효과적인지는 나중에 어떤 도구로 줄이느냐에 따라 달라집니다. 이 웹사이트의 압축 도구는 처리 가능한 이미지의 JPEG 품질을 낮추며, 픽셀 수는 줄이지 않습니다. 나중에 픽셀 수를 줄이려면 스캔본이 개별 이미지 파일로 있어야 하며 PDF를 만들 때 픽셀 수를 제한하거나 다시 스캔해야 합니다. 가장 확실한 방법은 시험해 보는 것입니다. 가장 작은 글씨가 포함된 대표적인 페이지를 두 가지 설정으로 스캔하고 가독성과 바이트 단위의 파일 크기를 비교하세요.
언제 컬러 대신 그레이스케일을 사용할 수 있나요?
문서의 색상에 수신자가 필요로 하는 정보가 담겨 있지 않다면 사용할 수 있습니다. 하지만 파란색 도장, 컬러 서명이나 색상으로 표시된 항목이 바로 중요한 증빙일 수 있습니다. 예를 들어 uni-assist에 업로드하는 스캔 문서는 모든 내용이 빠짐없이 포함되어 있고 읽을 수 있어야 합니다. 발급 기관의 서명과 도장, 전산 발급 표시 또는 검증 코드는 해당 증명서가 공식 문서임을 입증할 수 있습니다(uni-assist: 문서 업로드, 2026년 10월 기준). 다른 수신자는 자체 규칙을 적용하므로 항상 해당 수신자의 요구 사항을 따라야 합니다.
스캔에서 흑백은 보통 각 픽셀이 검은색 또는 흰색 중 하나라는 뜻입니다. 대개 용량을 줄일 수 있지만 흐린 글씨, 연한 도장이나 가는 선이 사라지거나 얼룩처럼 뭉칠 수 있습니다. 색상 모드는 스캐너나 스캔 앱에서 설정합니다. PDF 압축 도구는 컬러를 그레이스케일로 변환하지 않습니다.
가장자리와 자르기
스캔 앱의 자동 자르기는 어두운 테두리와 책상 배경을 제거하지만, 종이 가장자리의 페이지 번호, 검증 코드나 도장도 잘라낼 수 있습니다. 자른 후에는 모든 페이지를 확인하고, 증빙 역할을 하는 세부 정보를 잃기보다는 다시 스캔하세요.
동일한 스캔 페이지의 네 가지 버전
별도로 만든 동일한 예제 페이지의 PDF 네 개입니다. 각각 전체 페이지를 컬러 또는 회색조의 150 또는 300 PPI 스캔으로 구성했습니다. 파일은 개별적으로 만들었으며 압축기로 크기를 줄이지 않았습니다. 버전을 선택하고 컬러 300 PPI 기준 버전과 비교하세요.
두 이미지 중 하나에서 스크롤하면 확대된 영역을 이동할 수 있습니다. 이미지에 초점이 있으면 화살표 키로도 이동할 수 있으며, 두 이미지가 함께 움직입니다.
컬러, 150 PPI
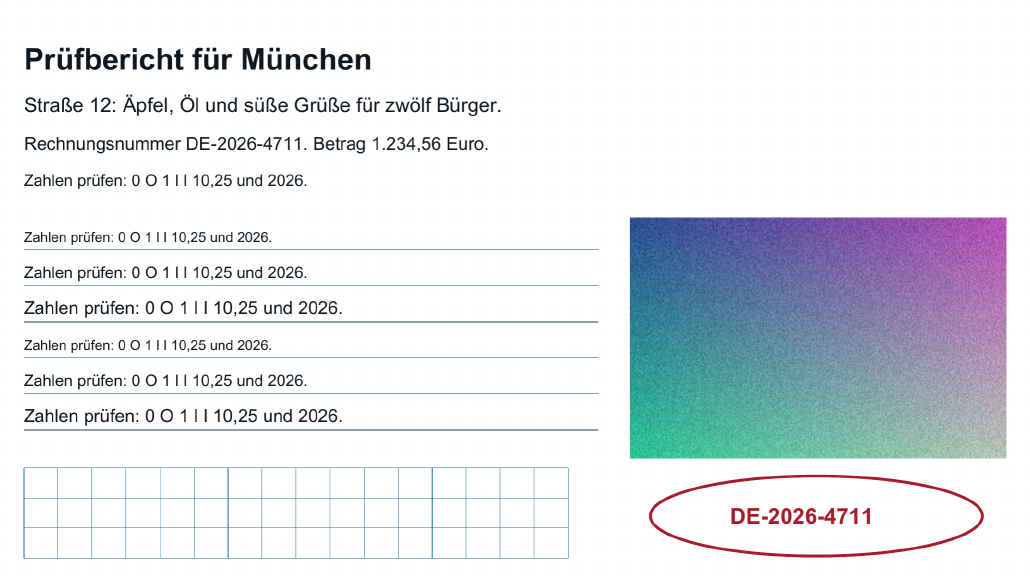
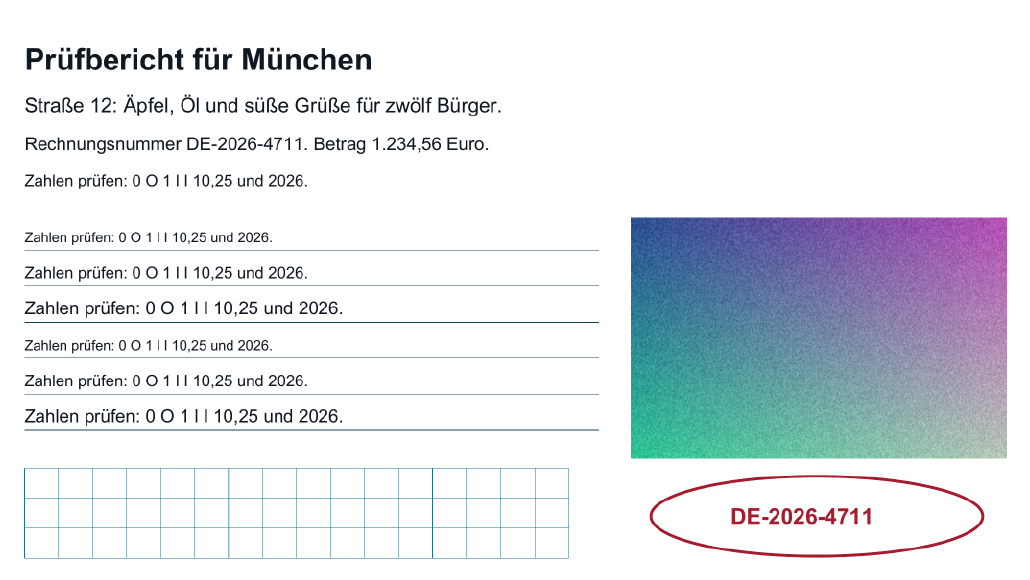
기준 버전과 같은 컬러이지만 가로와 세로 해상도가 각각 절반입니다. 가는 글씨와 가장자리를 살펴보세요.
회색조, 150 PPI
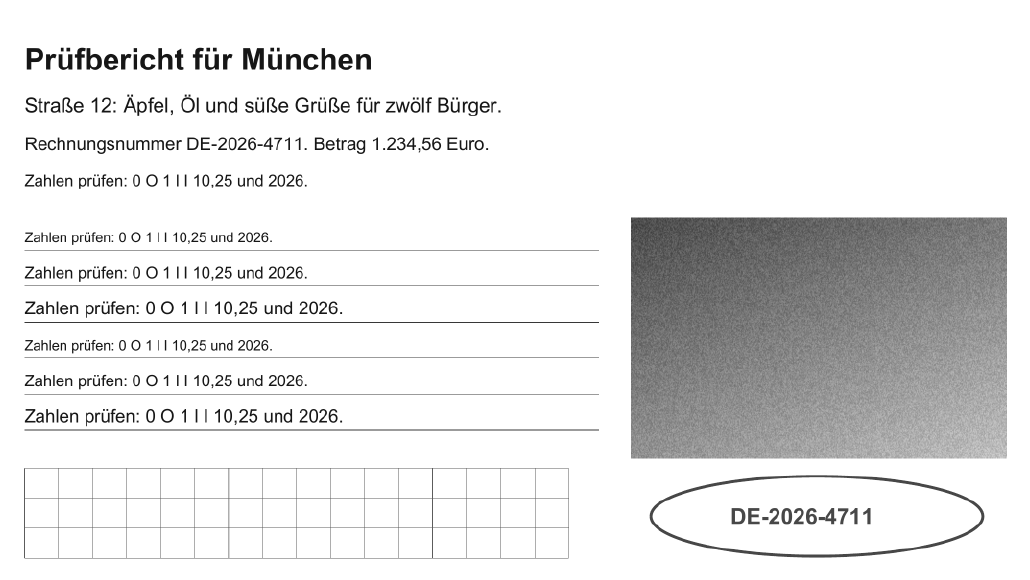
색상이 없고 가로와 세로 해상도가 각각 절반입니다. 기준 버전에서 색상으로 구분한 모든 요소를 여전히 구별할 수 있는지 확인하세요.
컬러, 300 PPI
비교에 사용하는 기준 버전입니다.
회색조, 300 PPI
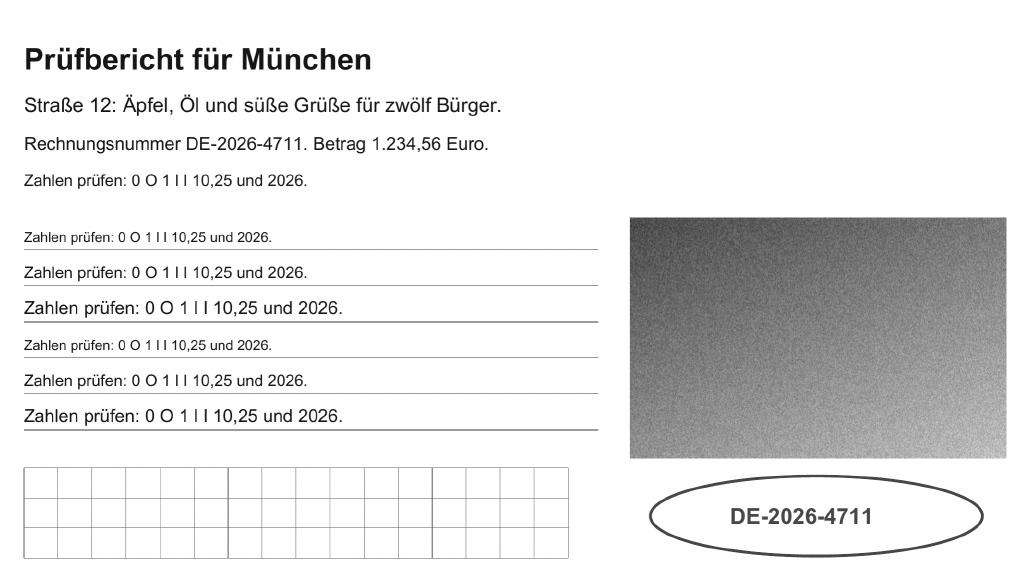
기준 버전과 해상도는 같지만 색상 정보는 없습니다.
| 버전 | 기준(바이트) | 버전(바이트) |
|---|---|---|
| 컬러, 150 PPI | 1,233,599 | 352,067 |
| 회색조, 150 PPI | 1,233,599 | 200,390 |
| 컬러, 300 PPI | 1,233,599 | 1,233,599 |
| 회색조, 300 PPI | 1,233,599 | 645,645 |
모든 버전에서 동일한 페이지 영역을 보여줍니다. 생성한 PDF에서 래스터 이미지로 변환했으며 후처리는 하지 않았습니다.
이 예제는 특정 해상도나 색상 설정을 권장하는 것이 아닙니다. 300 PPI라도 모든 텍스트의 가독성이 보장되지는 않으며, 150 PPI가 모든 상황에 충분한 것도 아닙니다. 해상도만으로 압축된 PDF의 크기를 예측할 수는 없습니다.
기존 PDF인가요, 개별 이미지인가요?
어떤 방법이 적합한지는 현재 어떤 파일을 가지고 있는지에 따라 달라집니다. 두 도구 모두 브라우저에서 파일을 처리하지만 변경하는 대상은 서로 다릅니다.
압축 도구가 스캔 PDF를 처리하는 방식
‘방식’에서 세 가지 압축 수준 중 하나를 선택할 수 있습니다. ‘무손실 최적화’는 파일 구조만 재정리하며 이미지를 의도적으로 변경하지 않습니다. ‘균형’과 ‘더 작은 파일’은 추가로 처리 가능한 이미지를 JPEG로 다시 인코딩하며, ‘더 작은 파일’은 더 강하게 압축합니다. ‘목표 크기 설정’에서는 압축 도구가 달성하려고 시도할 한도도 지정할 수 있습니다. 각 시도는 이전 결과가 아니라 원본에서 시작합니다. 이때 어떤 품질 단계가 사용되는지는 세 가지 방식이 구체적으로 변경하는 내용 안내에서 설명합니다.
다시 인코딩하는 대상은 충분히 크고 내장 QPDF 엔진이 처리할 수 있는 형식의 삽입 이미지뿐입니다. QPDF는 이미지를 다시 인코딩하지만 크기를 조정하지는 않습니다(QPDF 파일 크기 최적화 문서). 따라서 픽셀 크기와 페이지에서의 유효 해상도는 그대로 유지되며, 여기서는 스캔본의 DPI를 변경할 수 없습니다. 모든 스캔본에 처리 가능한 이미지가 들어 있는 것은 아니며, 모든 파일의 크기가 줄어드는 것도 아닙니다. 실제로 더 작고 검사를 통과한 결과만 채택합니다. 그렇지 않으면 절감량이 0 바이트인 원본을 반환합니다. 가능한 원인과 이후 대처 방법은 PDF 크기가 줄어들지 않음 안내에서 설명합니다.
압축 도구는 파일당 최대 50 MiB(52,428,800 바이트)의 PDF를 받습니다. 디지털 서명된 PDF, 암호화된 PDF, 비밀번호로 보호된 PDF 또는 구조에 오류가 있는 PDF는 처리하지 않습니다. 반면 스캔본의 자필 서명이나 도장은 페이지 이미지의 일부일 뿐이므로 문제가 되지 않습니다.
개별 이미지를 이용하는 방법의 장점
이미지를 PDF로 변환할 때 ‘원본 형식 유지’와 ‘JPEG로 압축’ 중에서 선택할 수 있습니다. JPEG 품질은 40에서 100까지 설정할 수 있으며 기본값은 85입니다. ‘픽셀 수 제한’을 사용하면 이미지를 JPEG로 다시 저장하고 가장 긴 변의 길이를 지정한 최댓값 이하로 조정합니다. 기본값은 2000 픽셀입니다. 이때 투명한 영역은 흰색으로 바뀝니다. 너무 크게 스캔한 이미지의 실제 크기를 줄일 수 있는 단계가 바로 여기입니다. 원본 이미지에는 별도의 제한이 적용됩니다. 최대 250개 이미지, 이미지당 최대 50 MiB 및 40 메가픽셀, 합계 최대 100 MiB입니다. 완성된 이미지 PDF 역시 최대 100 MiB까지 허용됩니다. 이는 결과 파일에 대한 제한이며, 나중에 압축 도구에서 선택할 수 있는 파일의 한도는 아닙니다.
기존 OCR 레이어는 유지되나요?
일반적으로 유지됩니다. 압축 도구는 페이지를 다시 래스터화하지 않고 처리 가능한 이미지의 인코딩과 파일 구조만 변경합니다. 따라서 이전 문자 인식으로 페이지 이미지 위에 보이지 않게 배치된 텍스트는 페이지의 일부로 남습니다. 그래도 저장된 파일에서 확인하세요. 문서에 확실히 있는 단어를 검색하고 한 줄을 선택해 보세요. 압축 도구는 새로운 문자 인식을 수행하지 않습니다. 따라서 텍스트 레이어가 없는 스캔 PDF는 크기를 줄인 후에도 텍스트 레이어가 없습니다. 검색 가능한 텍스트가 필요하다면 스캔 앱이나 OCR 기능이 있는 프로그램을 사용해야 합니다.
페이지 이미지로 변환하는 우회 방법은 무손실이 아닙니다
스캔본이 PDF로만 있다면 페이지를 이미지로 내보내고 이를 바탕으로 새 PDF를 만들 수는 있습니다. 하지만 이는 문서를 새로 구성하는 과정입니다. 결과는 이미지로만 이루어지고 기존 텍스트 또는 OCR 레이어는 사라지며, 모든 페이지가 다시 래스터화되고 인코딩됩니다. 여러 도구를 차례로 사용한다면 결과를 저장한 뒤 다음 도구에서 저장한 파일을 다시 선택하세요. 그 도구에서도 선택한 파일당 50 MiB 제한이 적용됩니다.
해상도와 파일 크기를 따로 측정하기
해상도는 종이의 일정한 길이에 몇 개의 픽셀이 들어가는지를 나타냅니다. 스캐너에서는 보통 DPI라는 설정 이름을 사용하지만, 생성되는 이미지에서는 인치당 픽셀 수, 즉 PPI를 뜻합니다. 한 인치는 25.4 mm입니다. 따라서 픽셀 = 길이(mm) ÷ 25.4 × PPI입니다. 210 × 297 mm인 A4 용지에 적용하면 다음과 같습니다.
페이지 크기를 그대로 둔 채 해상도를 절반으로 낮추면 너비와 높이도 각각 절반이 됩니다. 따라서 픽셀 수는 사분의 일로 줄어듭니다. 2,174,960은 정확히 8,699,840의 사분의 일입니다. 세 번째 행은 이미지 변환 시 기본 제한이 300 PPI 스캔에 어떤 영향을 미치는지 보여줍니다. 2480 × 3508이 1414 × 2000 픽셀로 바뀌어 원래 픽셀 수의 삼분의 일에 조금 못 미치게 됩니다. 이 이미지를 297 mm의 전체 높이로 인쇄한다면 약 171 PPI에 해당합니다. 하지만 완성된 페이지에서 실제 해상도는 이미지가 얼마나 크게 배치되는지, 즉 페이지 형식과 여백에 따라 달라집니다. 다른 형식과 해상도는 픽셀과 인쇄 크기 계산 계산기로 확인해 볼 수 있습니다.
DPI를 절반으로 낮추면 파일 크기가 항상 사분의 일이 되나요?
아닙니다. 위 계산은 바이트가 아니라 픽셀 수를 계산한 것입니다. PDF 안의 이미지가 차지하는 바이트 수는 내용을 얼마나 잘 압축할 수 있느냐에 따라 달라집니다. 노이즈와 섬세한 디테일은 균일한 영역보다 더 많은 용량이 필요하며, 압축 방식에 따라 픽셀마다 저장에 필요한 용량도 같지 않습니다. 여기에 텍스트 레이어, 글꼴, 파일 구조처럼 픽셀 수와 관계없는 PDF 구성 요소도 더해집니다. 따라서 픽셀 수가 사분의 일이 되어도 바이트 수는 사분의 일보다 많거나 적을 수 있습니다.
변경 효과가 충분한지는 완성된 파일로만 알 수 있습니다. 압축 도구는 이를 위해 원본, 결과와 절감한 크기를 바이트 단위로 표시하고 절감률을 백분율로 보여줍니다. MB로 반올림한 표시에는 작은 차이가 드러나지 않을 수 있으므로 바이트 값을 비교하세요. 해상도 자체는 스캐너나 개별 이미지 변환 과정에서 변경하며, 압축 도구는 해상도를 그대로 유지합니다.
예제: 150 또는 300 PPI에서의 A4 및 A5
특정 해상도에서 용지 크기에 필요한 픽셀 수를 보여주는 계산 예제입니다. 기본 설정은 세로 방향 A4, 150 PPI이며, 선택에 따라 A5, 가로 방향 또는 300 PPI로 바꿀 수 있습니다. 이 예제는 스캔이나 파일을 변경하지 않습니다. 150과 300 PPI는 예시 값이며 일반적인 권장값이 아닙니다.
픽셀 수 계산
사각형은 사용할 수 있는 공간에 맞춰 비례 축소 또는 확대된 도식입니다. 실제 인쇄 크기도, 파일 미리보기도 아닙니다. 기준이 되는 것은 숫자로 표시된 값입니다.
인쇄 크기
- 인쇄 너비
- 21 cm
- 인쇄 높이
- 29.7 cm
픽셀 치수
- 픽셀 너비
- 1,240 px
- 픽셀 높이
- 1,754 px
- 가로 해상도
- 149.981 PPI
- 세로 해상도
- 150.005 PPI
- 유효 해상도(더 낮은 값)
- 149.981 PPI
가로와 세로 해상도의 차이가 1퍼센트를 넘습니다. 이미지와 목표 크기의 가로세로 비율이 완전히 일치하지 않는다는 뜻입니다. 이미지를 이 치수에 정확히 맞추면 이미지가 왜곡됩니다.
픽셀 수는 가장 가까운 정수로 반올림됩니다. 이로 인해 각 축의 해상도가 목표 값과 약간 다를 수 있습니다.
이 계산으로는 PDF의 가독성, 이미지 품질 또는 파일 크기를 알 수 없습니다. 프린터의 DPI는 별개의 값이며 이미지의 PPI와 다릅니다.
스캔본과 결과를 빠짐없이 확인하기
크기를 줄인 스캔본은 중요한 내용이 모두 남아 있어야 사용할 수 있습니다. 원본을 보관하고 미리보기만이 아니라 저장된 파일을 확인하세요. 압축 도구의 미리보기는 같은 페이지의 원본과 결과를 나란히 보여주며, 페이지를 하나씩 넘겨 볼 수 있습니다. 하지만 텍스트 검색과 링크가 계속 작동하는지는 다운로드한 PDF를 뷰어에서 열어야 확인할 수 있습니다.
- 모든 페이지 살펴보기: 뒷면, 첨부 문서 또는 중간 페이지가 빠지지 않았나요?
- 가장자리 확인하기: 페이지 번호, 검증 코드와 종이 가장자리의 정보가 모두 남아 있나요?
- 가장 작은 글씨 확대하기: 성적, 날짜, 문서 번호와 각주를 명확하게 구별할 수 있나요? 3과 8 또는 1과 7처럼 혼동하기 쉬운 숫자에 주의하세요.
- 도장, 인장과 서명 확인하기: 알아볼 수 있으며, 수신자에게 색상이 필요한 경우 그 색상이 유지되어 있나요?
- 희미한 부분 확인하기: 연필, 흐려진 글씨와 먹지 사본의 내용이 얼룩이나 압축 무늬에 묻혀서는 안 됩니다.
- 원본에서 검색이 가능했다면 텍스트 검색 테스트하기: 알고 있는 단어를 검색하고 한 줄을 선택해 보세요.
- 바이트 단위의 크기를 수신자의 요구 사항과 비교하세요.
어떤 부분이 기준에 못 미친다면 원본에서 다시 시작하세요. 압축 도구에서 더 약한 방식을 사용하거나, 이미지 변환 설정을 바꾸거나, 새로 스캔하세요. 결과가 적합한지는 결국 저장된 파일의 바이트 수와 가독성으로 결정됩니다. 이미지 품질에서 구체적으로 무엇을 확인해야 하는지는 압축 후 PDF 품질 확인 안내에서 볼 수 있습니다.