छवि वाली PDF, टेक्स्ट वाली PDF या दोनों? पहले जाँचें, फिर शुरू करें
PDF को अपने PDF प्रोग्राम या ब्राउज़र में खोलें। फिर कोई ऐसा शब्द खोजें जो आपको पृष्ठ पर दिख रहा हो, जैसे पत्र के शीर्षलेख में मौजूद कोई नाम। इसके अलावा, किसी पंक्ति को चुनकर कॉपी करने की कोशिश करें। अगर खोज में कुछ नहीं मिलता और कुछ भी चुना नहीं जा सकता, तो पृष्ठ में केवल एक छवि है। टेक्स्ट पहचान इसी के लिए है। लेकिन अगर आपकी PDF में पहले से पूरे टेक्स्ट को खोजा और कॉपी किया जा सकता है, तो आम तौर पर आपको टेक्स्ट पहचान की ज़रूरत ही नहीं है।
मिश्रित सामग्री वाले पृष्ठ अस्वीकार क्यों किए जाते हैं
इसका एक आम उदाहरण ऐसा पत्र है जिसका शीर्षलेख PDF में वास्तविक टेक्स्ट के रूप में मौजूद है, जबकि नीचे का मुख्य पत्र स्कैन की गई छवि है। अगर टूल ऐसे पृष्ठ को तैयार टेक्स्ट वाले पृष्ठ के रूप में शामिल कर ले, तो स्कैन वाले हिस्से में खोजने योग्य टेक्स्ट नहीं होगा और इसका पता भी नहीं चलेगा। इसलिए यह हर ऐसी PDF को अस्वीकार करता है जिसमें एक भी पृष्ठ पर चयन योग्य टेक्स्ट और छवि दोनों हों। यह जाँच जानबूझकर सख्त रखी गई है। यह लोगो वाले सामान्य टेक्स्ट पृष्ठ पर भी लागू होती है, भले ही उसमें किसी पहचान की ज़रूरत न हो। साथ ही, पहले से मौजूद टेक्स्ट परत को कभी भी बिना बताए बदला या ठीक नहीं किया जाता, भले ही उसमें गलतियाँ हों।
फिर भी आगे बढ़ने के लिए ये तरीके अपनाएँ:
- अगर संबंधित पृष्ठ पहले से खोजने योग्य हैं, जैसे लोगो वाला आवरण पृष्ठ, तो आप उन्हें किसी कॉपी से हटा सकते हैं। या PDF को बाँट सकते हैं, ताकि केवल पूरी तरह स्कैन वाले पृष्ठों की पहचान की जाए। इसके बाद आप हिस्सों को फिर से जोड़ सकते हैं। अंत में तैयार फ़ाइल में खोज जाँचें।
- अगर मिश्रित सामग्री वाले पृष्ठ को पूरी तरह खोजने योग्य बनाना ज़रूरी है, तो उसे केवल छवि वाले पृष्ठ में बदलें। इसके लिए पृष्ठों को JPG के रूप में निर्यात करें और छवियों को फिर से एक PDF में जोड़ें। फिर इस PDF में टेक्स्ट पहचान चलाएँ। ध्यान रखें कि छवियों में टेक्स्ट साफ़ पढ़ने योग्य रहे। इस प्रक्रिया में पहले का वास्तविक टेक्स्ट भी छवि में बदल जाता है और फिर दोबारा पहचाना जाता है। इसलिए उसे भी बाकी टेक्स्ट की तरह जाँचें। इस तरीके से आप पुरानी, गलत टेक्स्ट परत को भी बदल सकते हैं।
- अगर मूल दस्तावेज़ आपके पास अब भी कागज़ पर है, तो उसे केवल छवियों वाली PDF के रूप में फिर से स्कैन करना अक्सर सबसे आसान तरीका होता है।
स्कैन की गई PDF को खोजने योग्य बनाएँ: चरण दर चरण
- “फ़ाइल चुनें” से कोई PDF चुनें या उसे दिए गए क्षेत्र में छोड़ें। एक बार में केवल एक फ़ाइल प्रोसेस होती है, जिसका आकार अधिकतम 50 MiB हो और जिसमें अधिकतम 20 पृष्ठ हों।
- “दस्तावेज़ की भाषा” में चुनें कि टेक्स्ट किस भाषा में लिखा है: जर्मन, अंग्रेज़ी या जर्मन और अंग्रेज़ी।
- “आउटपुट फ़ॉर्मैट” में “खोजने योग्य PDF” और “टेक्स्ट फ़ाइल (TXT, UTF-8)” में से चुनें।
- “टेक्स्ट पहचानें” पर क्लिक करें। पहली बार शुरू करने पर पृष्ठ अपना पहचान डेटा डाउनलोड करता है, जिसके लिए इंटरनेट कनेक्शन चाहिए। इसके बाद पृष्ठों पर एक-एक करके टेक्स्ट पहचान की जाती है। इसमें कितना समय लगेगा, यह पृष्ठों की संख्या और आपके डिवाइस पर निर्भर करता है। “रद्द करें” से आप कभी भी प्रक्रिया रोक सकते हैं। तब कोई फ़ाइल नहीं बनती, अधूरी फ़ाइल भी नहीं।
- “परिणाम संबंधी जानकारी” में पढ़ें कि क्या कुछ पृष्ठ बिना पहचान के शामिल किए गए या खाली थे। फिर “डाउनलोड करें” से फ़ाइल डाउनलोड करें।
- सहेजी गई फ़ाइल खोलें और उसे आगे भेजने या मूल फ़ाइल मिटाने से पहले नीचे बताए गए तरीके से जाँचें।
आपकी मूल फ़ाइल में कोई बदलाव नहीं होता; परिणाम हमेशा एक नई फ़ाइल होता है। इस प्रक्रिया के लिए न खाते की ज़रूरत है, न भुगतान की। “रीसेट करें” से आप अगली PDF के साथ शुरू कर सकते हैं।
खोजने योग्य PDF, टेक्स्ट फ़ाइल या Word दस्तावेज़?
टेक्स्ट पहचान से टेक्स्ट खोजा जा सकता है, लेकिन वह अपने आप संपादन योग्य नहीं बनता। आपको कौन-सी फ़ाइल चाहिए, यह इस बात पर निर्भर करता है कि आगे आप उसके साथ क्या करना चाहते हैं।
पृष्ठ की छवि में बदलाव नहीं होने के कारण खोजने योग्य PDF बिल्कुल स्कैन जैसी दिखती है। ऐसा तब भी होता है जब अदृश्य टेक्स्ट परत में कुछ शब्द गलत हों। पहचान सही हुई है या नहीं, यह केवल खोज और कॉपी किए गए टेक्स्ट से पता चलता है। इसके अलावा, खोजने योग्य PDF अपने आप न तो PDF/UA के अनुसार सुलभ होती है और न PDF/A के अनुसार अभिलेखीय PDF। यह टूल इन दोनों में से कोई भी नहीं बनाता।
उदाहरण: स्कैन से खोज योग्य PDF बनाना
स्वयं बनाया गया उदाहरण: एक पृष्ठ वाली स्कैन की गई PDF में केवल एक छवि होती है और चुनने योग्य टेक्स्ट नहीं होता। टेक्स्ट पहचान के बाद PDF में टेक्स्ट की एक परत होती है। उसमें आप खोज सकते हैं और टेक्स्ट कॉपी कर सकते हैं।
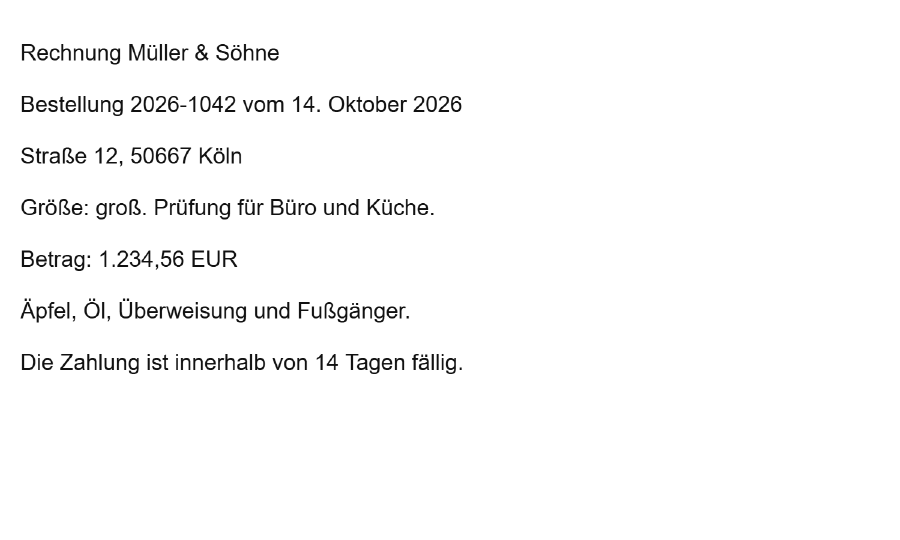
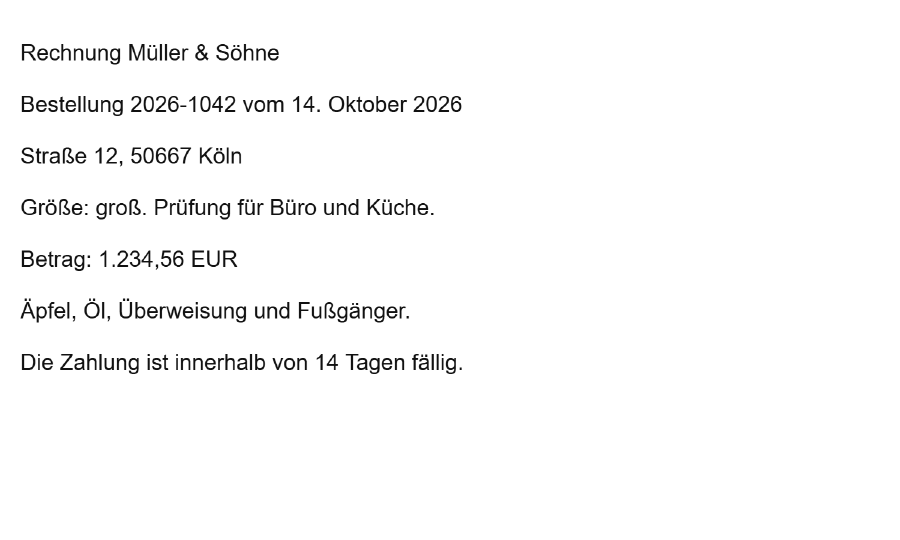
ये चित्र पृष्ठों की छवियों के अंश हैं। आप केवल डाउनलोड की गई PDF या निकाले गए टेक्स्ट में खोज और कॉपी कर सकते हैं।
खोजा जाने वाला शब्द Müller
खोजने योग्य PDF से पहचाना गया टेक्स्ट
Rechnung Müller & Söhne
Bestellung 2026-1042 vom 14. Oktober 2026
Straße 12, 50667 Köln
Größe: groß. Prüfung für Büro und Küche.
Betrag: 1.234,56 EUR
Äpfel, Öl, Überweisung und Fußgänger.
Die Zahlung ist innerhalb von 14 Tagen fällig.
खोजने योग्य PDF को अपने PDF प्रोग्राम में खोलें। वहाँ „Müller“ खोजें या टेक्स्ट को कॉपी करने के लिए चुनें। स्कैन की गई मूल फ़ाइल में ऐसा कोई टेक्स्ट नहीं है जिसे खोजा जा सके।
दोनों पृष्ठ एक जैसे दिखते हैं। अंतर फ़ाइल में है: खोज योग्य PDF में एक अतिरिक्त अदृश्य टेक्स्ट परत होती है। „Müller“ खोजने पर वह शब्द मिल जाता है, और आप टेक्स्ट चुनकर कॉपी कर सकते हैं।
टेक्स्ट पहचान शब्दों या संख्याओं को गलत पढ़ सकती है। यह उदाहरण आपके अपने दस्तावेज़ों के बारे में कुछ नहीं बताता। अपने परिणाम में विशेष रूप से नाम, राशियाँ और उमलाउट वाले अक्षर जाँचें।
भाषा चुनें: जर्मन, अंग्रेज़ी या दोनों
भाषा की सेटिंग पहचान प्रणाली को बताती है कि किन शब्दों और अक्षरों की अपेक्षा करनी है। ä, ö, ü और ß वाले जर्मन टेक्स्ट के लिए जर्मन चुनें। अगर किसी दस्तावेज़ में दोनों भाषाएँ हैं, जैसे अंग्रेज़ी तकनीकी शब्दों या अंग्रेज़ी पते वाला जर्मन पत्र, तो जर्मन और अंग्रेज़ी चुनें। यह टूल अन्य भाषाओं के लिए नहीं बनाया गया है।
भाषा चुनने से कोई अनुवाद नहीं होता। टेक्स्ट उसी भाषा में पहचाना जाता है जिसमें वह स्कैन पर मौजूद है। पहचान की सुविधा छपे हुए टेक्स्ट के लिए है; यह हस्तलिखित टेक्स्ट को भरोसेमंद ढंग से नहीं पहचानती।
परिणाम जाँचें: नाम, संख्याएँ और उमलाउट वाले अक्षर
टेक्स्ट पहचान प्रणाली छवि के पिक्सेल से अक्षरों का अनुमान लगाती है। इसमें गलतियाँ हो सकती हैं, खास तौर पर अंकों, व्यक्तियों या स्थानों के नामों और एक जैसे दिखने वाले चिह्नों में। इसलिए ज़रूरी दस्तावेज़ों की थोड़ी जाँच करना उपयोगी है:
- सहेजी गई PDF खोलें और Ctrl+F (Mac: Cmd+F) से कुछ ऐसे शब्द खोजें जो आपको स्कैन पर दिखाई देते हैं। बेहतर होगा कि कोई नाम, उमलाउट या ß वाला शब्द जैसे “Straße”, और कोई संख्या चुनें।
- कोई अनुच्छेद चुनें, उसे टेक्स्ट प्रोग्राम में कॉपी करें और स्कैन से तुलना करें। क्या नाम, 1,234.56 जैसी रकम, तारीखें, फ़ाइल संदर्भ संख्याएँ और उमलाउट वाले अक्षर सही हैं? क्या 0 और O या 1 और l जैसे मिलते-जुलते चिह्न आपस में बदल गए हैं?
- कॉलम और तालिकाओं में क्रम पर ध्यान दें। कॉलम और तालिका के सेल दोबारा नहीं बनाए जाते। इसलिए कॉपी किए गए टेक्स्ट में उनका क्रम पृष्ठ से अलग हो सकता है।
- अगर आपने टेक्स्ट फ़ाइल चुनी है, तो उन्हीं जगहों को सीधे फ़ाइल में जाँचें।
इस टूल में आप पहचाने गए टेक्स्ट की गलतियाँ ठीक नहीं कर सकते। ज़रूरी जानकारी के लिए पृष्ठ की दिखाई देने वाली छवि पर भरोसा करें, कॉपी किए गए टेक्स्ट पर नहीं।
बेहतर मूल सामग्री, बेहतर पहचान
कई गलतियाँ स्कैन करते समय ही पैदा हो जाती हैं, जैसे बहुत कम रिज़ॉल्यूशन, तिरछे स्कैन किए गए पृष्ठ, कम कंट्रास्ट, धब्बे या बहुत छोटे अक्षर। इसलिए ज़रूरी दस्तावेज़ों को जहाँ तक हो सके सीधा, स्पष्ट और अच्छे कंट्रास्ट के साथ स्कैन करें। सामान्य अक्षर आकार के लिए लगभग 300 dpi उपयोगी है। यहाँ तिरछे पृष्ठ अपने आप सीधे नहीं किए जाते। अगर कोई पृष्ठ बगल की ओर घूमा हुआ या उल्टा है, तो उसे पहले घुमाएँ, ताकि टेक्स्ट सीधा दिखाई दे। रिज़ॉल्यूशन, तिरछापन और छवि में दानेदार शोर पहचान को कैसे प्रभावित करते हैं, यह अंग्रेज़ी में उपलब्ध टेक्स्ट पहचान के लिए छवि की गुणवत्ता संबंधी मार्गदर्शिका में बताया गया है।
सीमाएँ और संदेश: आगे क्या करें
कई फ़ाइलों को कतार में लगाने की सुविधा नहीं है। आप पहचान के लिए अलग-अलग पृष्ठ भी नहीं चुन सकते; PDF के सभी पृष्ठ हमेशा प्रोसेस किए जाते हैं। तालिका बताती है कि फ़ाइल कब अस्वीकार होती है या सूचना कब दिखाई देती है और तब आप क्या कर सकते हैं।
क्या PDF आपके डिवाइस पर रहती है? और क्या यह बिना इंटरनेट के काम करता है?
आपकी PDF इसी ब्राउज़र में प्रोसेस होती है और किसी सर्वर को नहीं भेजी जाती। टेक्स्ट पहचान के लिए पृष्ठ केवल अपना प्रोग्राम और चुनी हुई भाषा का डेटा डाउनलोड करता है। ये इसी वेबसाइट से डाउनलोड होते हैं, किसी बाहरी सेवा से नहीं।
इसलिए शुरू करते समय इंटरनेट कनेक्शन चाहिए, क्योंकि पहचान डेटा के बिना कोई फ़ाइल प्रोसेस नहीं की जा सकती। बाद में दोबारा आने पर भी पृष्ठ को यह डेटा फिर से लोड करना पड़ सकता है। पूरी तरह बिना इंटरनेट के शुरू करने की व्यवस्था नहीं है और इसका आश्वासन भी नहीं दिया जाता।
वेबसाइट सामान्य रूप से आपकी फ़ाइलों को कैसे संभालती है, यह सुरक्षा और फ़ाइल प्रोसेसिंग वाले पृष्ठ पर बताया गया है।