अपनी PDF को DOCX फ़ाइल में ऐसे बदलें
- जाँचें कि आपकी PDF में टेक्स्ट चुना जा सकता है या नहीं: उसे किसी PDF प्रोग्राम में खोलें और कुछ शब्दों पर माउस खींचें। यदि केवल पूरे पृष्ठ के चारों ओर एक फ़्रेम चुना जाता है या कुछ भी नहीं चुना जाता, तो वह स्कैन है। ऐसे में नीचे स्कैन की गई PDF वाला अनुभाग मदद करेगा।
- “फ़ाइल चुनें” पर क्लिक करें या PDF को फ़ाइल छोड़ने वाले क्षेत्र में खींचकर छोड़ें। हर बार ठीक एक फ़ाइल बदली जाती है।
- “DOCX में परिवर्तित करें” पर क्लिक करें। “रद्द करें” से आप प्रोसेसिंग रोक सकते हैं; तब कोई फ़ाइल नहीं बनती।
- “परिणाम” के अंतर्गत “परिणाम संबंधी जानकारी” पढ़ें। वहाँ, उदाहरण के लिए, बताया जाता है कि छवियाँ छोड़ी गई हैं, तालिकाएँ दोबारा बनाई गई हैं या दो कॉलम एक के बाद एक लिए गए हैं।
- DOCX फ़ाइल सहेजने के लिए “डाउनलोड करें” पर क्लिक करें।
- सहेजी गई फ़ाइल खोलें और उसे आगे देने या PDF मिटाने से पहले नीचे बताए गए तरीके से जाँचें।
इस प्रक्रिया में आपकी PDF नहीं बदलती; DOCX फ़ाइल एक नई, अलग फ़ाइल होती है। परिणाम में “पृष्ठ” की जानकारी PDF से संबंधित है। Word में पृष्ठों की संख्या अलग हो सकती है, क्योंकि टेक्स्ट की पंक्तियाँ और पृष्ठ नए सिरे से व्यवस्थित होते हैं। “रीसेट करें” से आप टूल को अगली फ़ाइल के लिए तैयार कर सकते हैं।
पृष्ठ की छवि के बजाय संपादन योग्य टेक्स्ट
कुछ रूपांतरण हर PDF पृष्ठ को केवल एक छवि के रूप में Word दस्तावेज़ में रख देते हैं। वह मूल जैसा दिखता है, लेकिन अलग-अलग शब्दों को न चुना जा सकता है, न बदला जा सकता है। यहाँ इसका उलटा होता है: वास्तविक अनुच्छेद बनते हैं और सरल संख्यात्मक तालिकाओं के मामले में वास्तविक Word तालिका सेल बनते हैं। पृष्ठों की छवियाँ नहीं डाली जातीं।
इस प्रक्रिया में नया दस्तावेज़ बनने का कारण PDF प्रारूप है। PDF मुख्य रूप से यह सहेजती है कि पृष्ठ पर कौन-सा टेक्स्ट कहाँ स्थित है, लेकिन यह नहीं कि कौन-सी पंक्तियाँ मिलकर एक अनुच्छेद बनाती हैं या कौन-से मान मिलकर तालिका की एक पंक्ति बनाते हैं। Word में हर रूपांतरण के दौरान इन संबंधों का नए सिरे से पता लगाना पड़ता है, इसलिए रूप बदल सकता है। Microsoft ने Word में PDF खोलने की अपनी सुविधा के लिए इसे Word में PDF खोलना में समझाया है।
ऐसे जाँचें कि फ़ाइल वास्तव में संपादन योग्य है
इसके लिए केवल पहले पृष्ठ पर एक नज़र डालना पर्याप्त नहीं है। सहेजी गई फ़ाइल में ये जाँच करें:
- कोई शब्द चुनें और उसकी जगह दूसरा टेक्स्ट लिखें।
- यदि फ़ाइल में तालिका है, तो किसी तालिका सेल में एक मान बदलें।
- किसी अनुच्छेद में एक वाक्य जोड़ें और देखें कि उसके बाद का टेक्स्ट उसी के अनुसार आगे खिसकता है या नहीं।
- फ़ाइल सहेजें, बंद करें और दोबारा खोलें। आपके बदलाव सुरक्षित रहने चाहिए।
लेआउट, फ़ॉन्ट, तालिकाएँ और छवियाँ: क्या शामिल होता है
टेक्स्ट लिया जाता है, पृष्ठ की डिज़ाइन नहीं। आपकी PDF के अलग-अलग हिस्सों के लिए इसका यह अर्थ है:
जब रूप बिल्कुल सही होना ज़रूरी हो
यदि आपको पृष्ठ का मूल रूप चाहिए, जैसे लेटरहेड, फ़्लायर या बहुत सारे ग्राफ़िक्स वाले पृष्ठों के मामले में, तो उसे नए अनुच्छेदों वाले टेक्स्ट में बदलना सही तरीका नहीं है। सबसे अच्छा विकल्प वह मूल फ़ाइल है, जिससे PDF बनाई गई थी। भेजने वाले से वह फ़ाइल माँगें। यदि आप किसी पृष्ठ को केवल बिना बदलाव के दिखाना चाहते हैं, तो उसे JPG के रूप में सहेज सकते हैं और छवि के रूप में डाल सकते हैं, लेकिन तब टेक्स्ट संपादन योग्य नहीं होगा। Word खुद भी PDF खोल सकता है; Microsoft के अनुसार उसमें भी रूप बदल सकता है।
उदाहरण: PDF से संपादन योग्य DOCX फ़ाइल बनाना
स्वयं बनाया गया उदाहरण: तालिका वाली दो पृष्ठों की जर्मन PDF को DOCX फ़ाइल में परिवर्तित किया गया। प्रत्येक चित्र में पहले पृष्ठ का केवल एक हिस्सा दिखाया गया है।
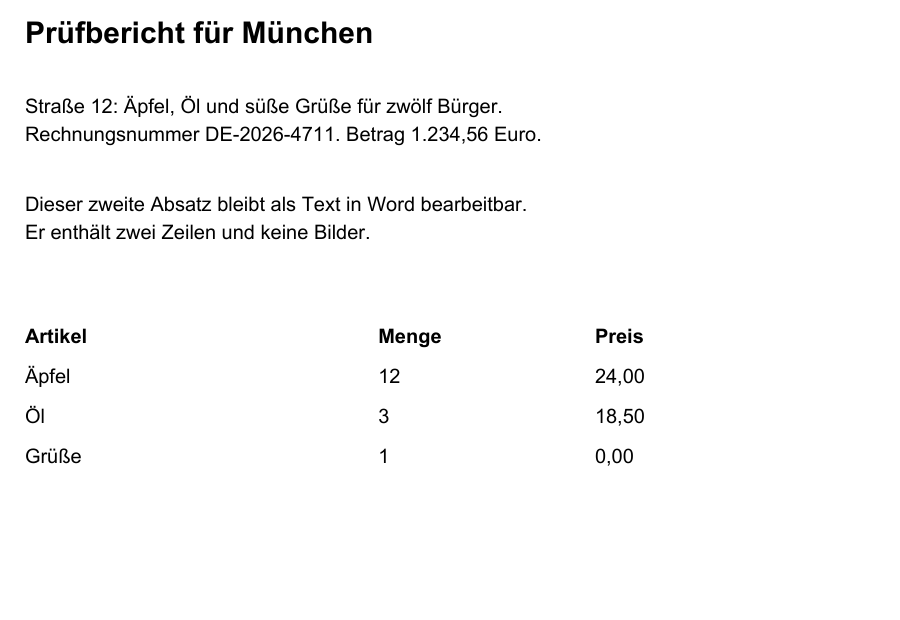
बाद में: LibreOffice पूर्वावलोकन में DOCX परिणाम, पृष्ठ 1 का एक हिस्सा
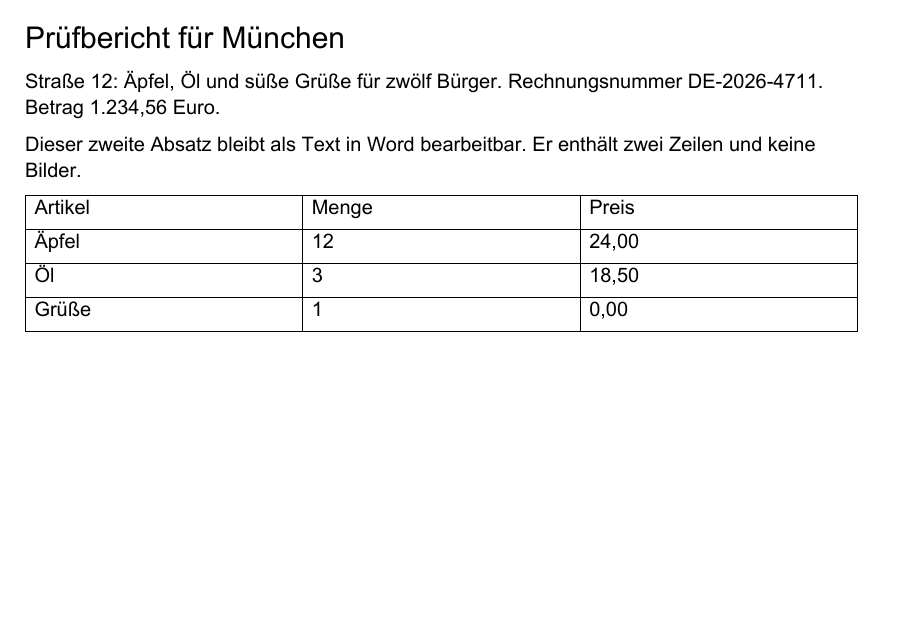 उदाहरण की रूपांतरित DOCX फ़ाइल डाउनलोड करें
चित्रों में दो पृष्ठों में से केवल पहले पृष्ठ का एक अंश दिखाया गया है। पूरी तुलना करने के लिए दोनों फ़ाइलें डाउनलोड करें।
चुनने और कॉपी करने के लिए DOCX फ़ाइल से लिया गया टेक्स्ट अंश
Prüfbericht für München
Straße 12: Äpfel, Öl und süße Grüße für zwölf Bürger. Rechnungsnummer DE-2026-4711.
Betrag 1.234,56 Euro.
Dieser zweite Absatz bleibt als Text in Word bearbeitbar. Er enthält zwei Zeilen und keine
Bilder.
Artikel Menge Preis
Äpfel 12 24,00
Öl 3 18,50
Grüße 1 0,00
DOCX फ़ाइल में सामग्री संपादन योग्य टेक्स्ट के रूप में और तालिका वास्तविक तालिका के रूप में मौजूद है। इस उदाहरण में “München” जैसे शब्दों के उमलाउट वाले अक्षर और “1.234,56” जैसी संख्याएँ बनी रहीं। हालाँकि, पंक्तियाँ मूल दस्तावेज़ से अलग जगह पर टूटती हैं और तालिका को सीमा रेखाओं के साथ फिर से बनाया गया है।
यह पूर्वावलोकन LibreOffice से लिया गया है, Microsoft Word से नहीं। कौन-सा फ़ॉन्ट दिखेगा, यह आपके डिवाइस पर मौजूद फ़ॉन्ट पर निर्भर करता है। लेआउट और पृष्ठ विभाजन मूल दस्तावेज़ से अलग हो सकते हैं।
स्कैन की गई PDF: पहले टेक्स्ट पहचानें
कंप्यूटर के लिए स्कैन पृष्ठ की एक तस्वीर है। उसमें ऐसा टेक्स्ट नहीं होता, जिसे चुना जा सके। यह टूल केवल पहले से मौजूद टेक्स्ट पढ़ता है और छवियों में लिखे अक्षरों को नहीं पहचानता। इसलिए यदि एक भी पृष्ठ केवल छवि से बना है, तो पूरा रूपांतरण रुक जाता है, भले ही बाकी पृष्ठों में टेक्स्ट हो। यह तरीका अपनाएँ:
- टेक्स्ट पहचान (OCR) से PDF को खोजने योग्य बनाएँ। यह हर बार अधिकतम 20 पृष्ठ प्रोसेस करता है और जर्मन, अंग्रेज़ी या दोनों भाषाओं का टेक्स्ट पहचानता है।
- पहचाने गए टेक्स्ट की जाँच करें, विशेष रूप से नामों, संख्याओं और राशियों की। अन्यथा टेक्स्ट पहचानने की त्रुटियाँ बिना बदलाव के DOCX फ़ाइल में पहुँच जाएँगी।
- इसके बाद खोजने योग्य PDF को यहाँ चुनें और बदलें।
यह उन PDF पर भी लागू होता है, जिनमें पहले से टेक्स्ट परत है, जैसे सीधे स्कैनर से बनी PDF। यह टूल मौजूद टेक्स्ट को जैसा है वैसा ही लेता है और यह नहीं जाँचता कि उसे सही पहचाना गया था या नहीं। यदि परिणाम बताता है कि छवियाँ शामिल नहीं की गईं, तो देखें कि उनमें से किसी में टेक्स्ट था या नहीं। अन्यथा किसी मुख्यतः डिजिटल पृष्ठ पर मौजूद स्कैन किया गया हिस्सा Word फ़ाइल में छूट जाएगा। ऐसे मिश्रित पृष्ठों को टेक्स्ट पहचानने वाला टूल भी प्रोसेस नहीं करता; तब आपको वह हिस्सा खुद जोड़ना होगा।
परिणाम की जाँच: जर्मन दस्तावेज़ों में किन बातों पर ध्यान दें
जर्मन दस्तावेज़ों में विशेष अक्षरों, संख्या प्रारूपों और पहचान संख्याओं पर विशेष ध्यान देना ज़रूरी है। एक जर्मन उदाहरण दस्तावेज़ में „Straße 12“, „Äpfel, Öl und süße Grüße“, राशि „1.234,56“, चालान संख्या „DE-2026-4711“ और आसानी से भ्रमित करने वाला क्रम „0 O 1 l I“ जैसी जानकारी DOCX फ़ाइल में बिना बदलाव के पहुँची। आपकी PDF के साथ भी ऐसा होगा या नहीं, यह इस बात पर निर्भर करता है कि उसका टेक्स्ट कैसे सहेजा या पहचाना गया था। इसलिए मूल से इनकी तुलना करें:
- ä, ö, ü और ß वाले नाम, सड़कों के नाम और स्थानों के नाम
- हज़ारों के विभाजक के रूप में बिंदु और दशमलव के लिए अल्पविराम वाली राशियाँ तथा तारीखें
- चालान संख्याएँ, ग्राहक संख्याएँ और फ़ाइल संदर्भ, जिनमें 0 और O या 1, l और I के बीच भ्रम हो सकता है
- अनुभागों का क्रम, विशेष रूप से दो कॉलम वाले पृष्ठों, फ़ुटनोट और पादलेखों के मामले में
- दोबारा बनाई गई तालिकाएँ पंक्ति दर पंक्ति: क्या हर मान सही सेल में है?
- वह सामग्री, जो PDF में छवि, ग्राफ़िक या टिप्पणी के रूप में थी और इसलिए शामिल नहीं हुई
यदि टेक्स्ट के किसी हिस्से को पढ़ने योग्य अक्षरों के रूप में नहीं निकाला जा सकता, तो रूपांतरण एक संदेश के साथ रुक जाता है। ऐसे में अक्सर PDF को उसके मूल प्रोग्राम से दोबारा बनाना मददगार होता है। जब फ़ाइल का संपादन पूरा हो जाए और उसे फिर PDF बनाना हो, तो Word या अपने टेक्स्ट प्रोग्राम में सीधे PDF के रूप में सहेजें या निर्यात करें। Word को PDF में बदलें का इस्तेमाल केवल तभी किया जा सकता है, जब आपका दस्तावेज़ एक ही Word अनुभाग से बना हो। कई पृष्ठों वाली PDF से बने परिणामों में हर पृष्ठ का अपना अनुभाग होता है; यह कन्वर्टर ऐसी फ़ाइलें स्वीकार नहीं करता।
कौन-सी PDF बदली जा सकती हैं
आप हर बार अधिकतम 50 MiB, 100 पृष्ठों और 3,00,000 टेक्स्ट अक्षरों वाली एक PDF बदल सकते हैं। टेक्स्ट क्षैतिज रूप से बाएँ से दाएँ चलना चाहिए, जैसा जर्मन दस्तावेज़ों में सामान्य है। परिणाम हमेशा DOCX फ़ाइल होता है; पुराना DOC प्रारूप नहीं बनाया जाता।
रूपांतरण के लिए आपको खाते की ज़रूरत नहीं है, टूल में भुगतान का कोई चरण नहीं है और आपको कुछ इंस्टॉल नहीं करना पड़ता; रूपांतरण किसी अद्यतन ब्राउज़र में चलता है। वर्तमान में लागू शर्तें कीमतें और सीमाएँ में मिलेंगी।
क्या PDF आपके डिवाइस पर ही रहती है?
रूपांतरण की प्रक्रिया के लिए, हाँ। PDF आपके ब्राउज़र की RAM में पढ़ी जाती है और DOCX फ़ाइल भी वहीं बनती है। इसके लिए दस्तावेज़ किसी सर्वर पर नहीं भेजा जाता। हालाँकि, आपका ब्राउज़र वेबपृष्ठ और टूल के प्रोग्राम घटकों को सामान्य तरीके से इस वेबसाइट से लोड करता है। इसलिए पृष्ठ खोलते समय इंटरनेट कनेक्शन चाहिए; पूरी तरह इंटरनेट के बिना रूपांतरण होने का आश्वासन नहीं दिया जाता।
“डाउनलोड करें” के ज़रिए DOCX फ़ाइल उस स्थान पर सहेजी जाती है, जहाँ आपका ब्राउज़र डाउनलोड सहेजता है। यदि आप किसी साझा डिवाइस पर काम कर रहे हैं, तो इस्तेमाल के बाद प्रति मिटा दें। इस वेबसाइट पर फ़ाइल प्रोसेसिंग कैसे काम करती है, यह सुरक्षा पृष्ठ समझाता है। डेटा संभालने के बारे में जानकारी गोपनीयता नीति में मिलेगी।